传统的 AI 视频生成工具多依赖扩散模型直接渲染像素,创作者在调整画面细节时往往面临“黑盒”输出的不可控性,微小的提示词修改可能导致画面结构的完全崩塌。开发者 yihui-dev 维护的开源项目 awesome-opus5-5-videos 提供了一条截然不同的技术路径:利用 Claude Opus 5.5 的代码生成能力,通过编写 HTML、Canvas、SVG 或 Three.js 等前端代码来渲染视觉动画。代码生成路径将 AI 视觉创作从不可拆解的黑盒,变成了具备极高可控性、可交互性且能通过文本精确复现的开源工作流。
对于需要探索 AI 代码生成能力边界的前端开发者与设计师而言,该项目将抽象的模型能力转化为了具体的任务解决方案。截至 2026 年 9 月 29 日,仓库已收录 475 个视频案例及其背后的完整提示词,并保持着由 AI 协同参与的高频更新。资源被系统划分为动态图形、解释性视频、3D 场景以及游戏与交互四大类别。假设一位创作者需要开发一个带有粒子特效的 3D 交互网页背景,他可以直接在对应分类中检索相似案例,提取结构化提示词,从而跳过从零构建物理引擎和渲染逻辑的繁琐步骤。基于代码的视觉创作使得生成的内容天然具备可编程属性。
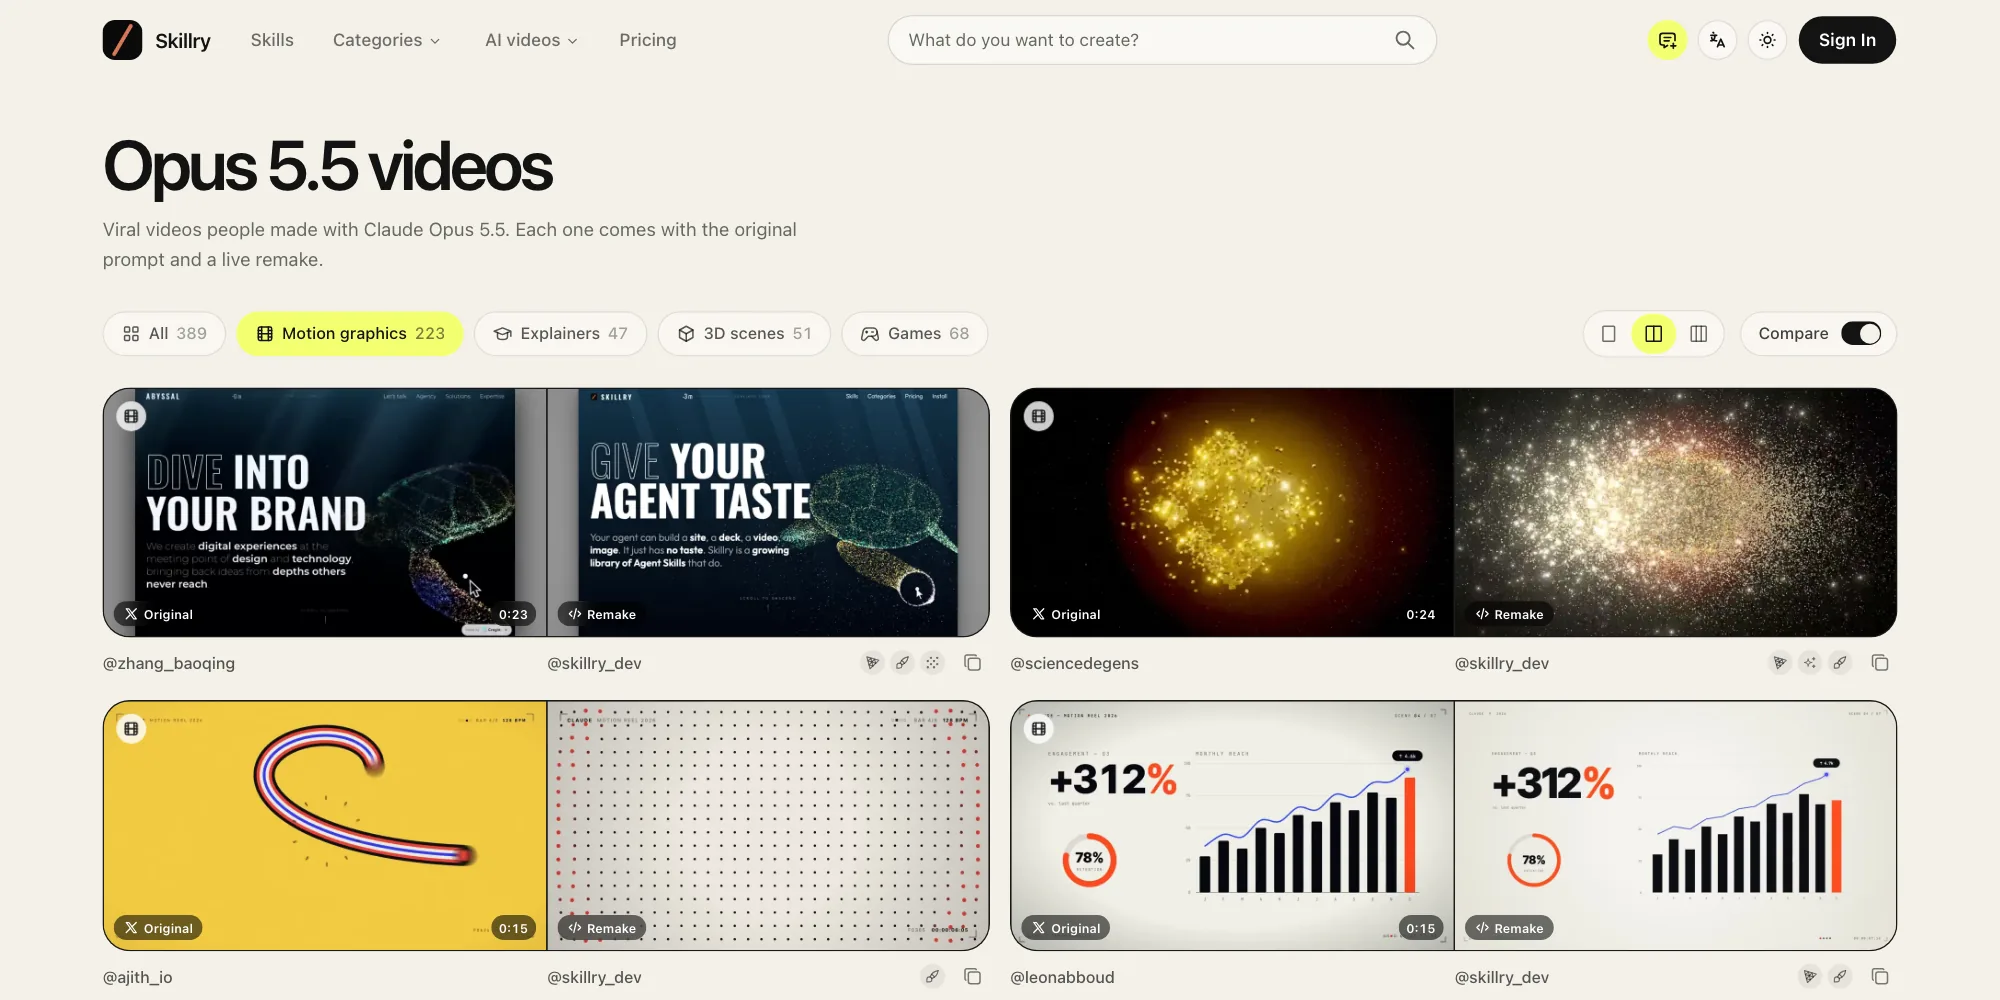
在实际复现工作流中,创作者可以通过 GitHub 仓库的 prompts/ 目录或 data/videos.json 文件获取结构化数据,每条记录均链接至创作者的原始发布帖,方便直接复制到本地 AI Agent 中进行测试。为了进一步降低验证门槛,项目与在线平台 Skillry 深度联动。用户无需在本地配置复杂的开发环境,即可在 Skillry 上并排观看原版视频与基于提示词的实时重制版,直观对比代码渲染的最终效果。
前端代码渲染机制赋予了视觉内容极强的逻辑控制力与二次修改空间,但其能力边界同样明确。由于依赖前端代码的渲染能力,该方案在生成极度逼真的写实视频或复杂的物理流体模拟时,表现可能不如专用的视频扩散模型。它更适合那些需要精确控制视觉逻辑、追求高交互性以及要求代码级可复现的开发者与 AI 创作者。