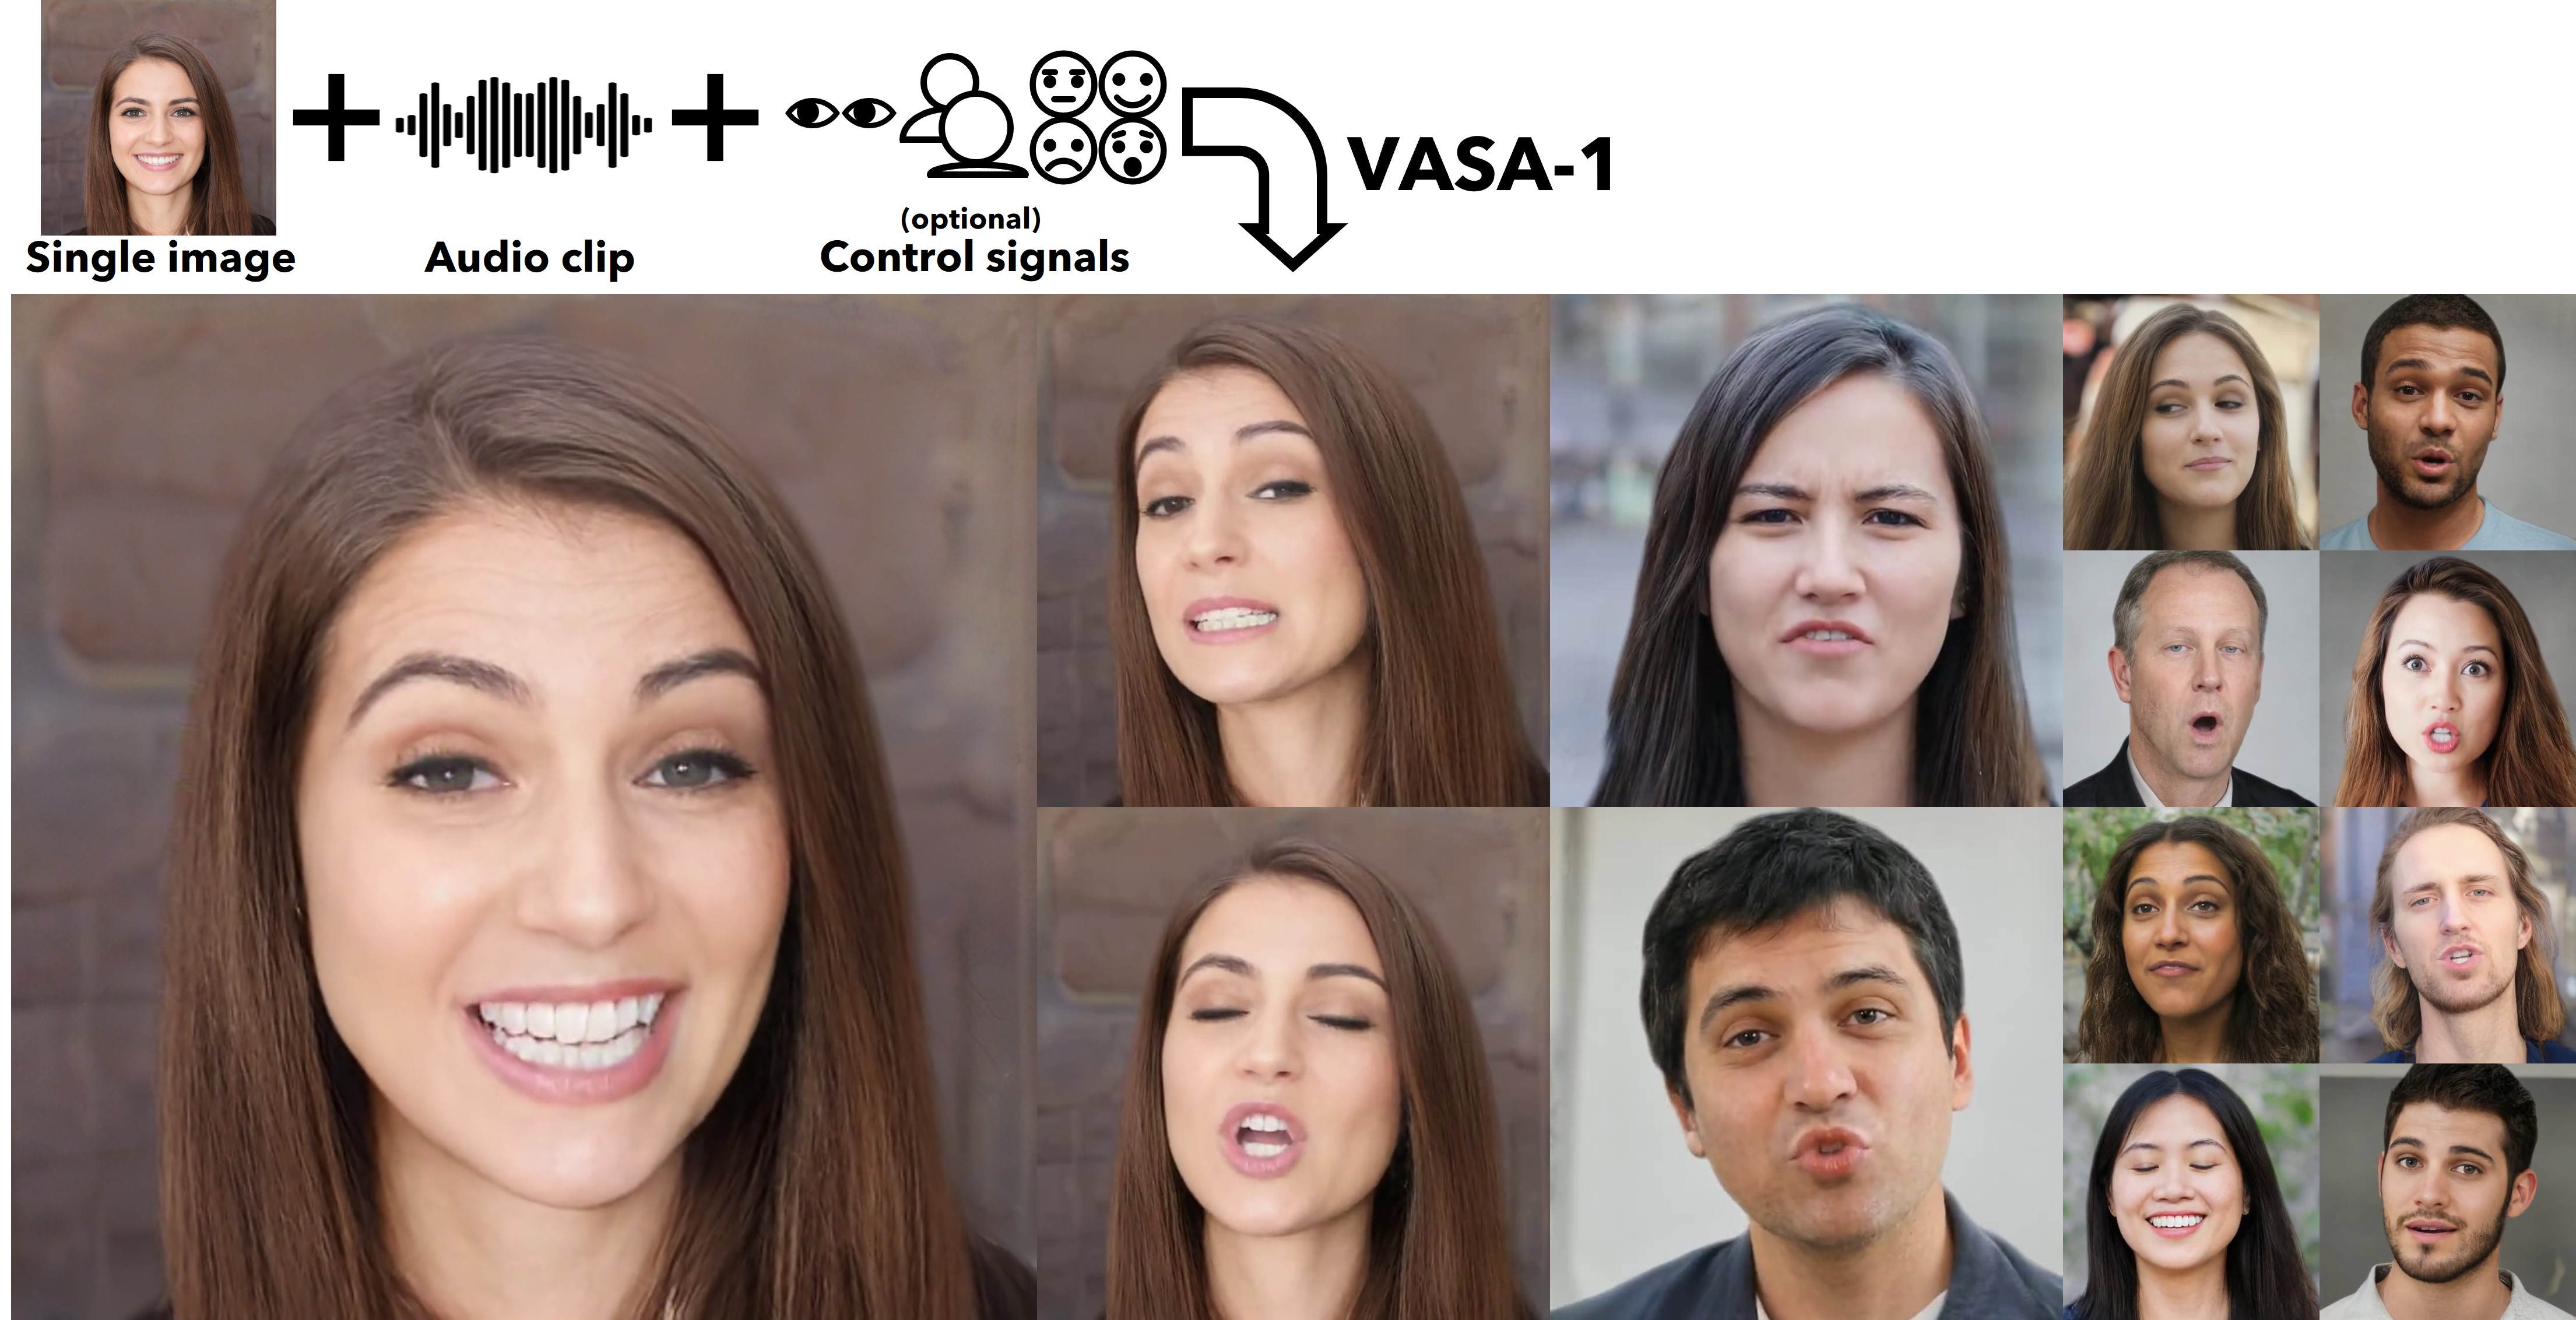
微软亚洲研究院最近推出了一个名为VASA-1的创新工具,标志着视觉和听觉人工智能领域的一个重大突破。VASA-1能够将单张静态图片与音频文件结合,生成具有动态面部表情和头部动作的视频,让图片中的人物仿佛“活”了起来,能够说话甚至唱歌。
功能介绍
VASA-1的核心功能是通过先进的AI算法,分析音频文件中的语音,并将这些语音同步到图片中的人物嘴型。不仅限于真实人物的照片,VASA-1甚至可以使艺术作品中的人物,如著名的《蒙娜丽莎》,以视频形式呈现出说话或唱歌的动态。
应用场景
VASA-1的应用潜力极为广泛:
- 教育领域: 可以用来创建交互式的教学材料,如历史人物的讲解视频,使学习内容更加生动有趣。
- 娱乐产业: 在电影和游戏中,VASA-1可以用来生成复杂的动态角色,提高视觉效果的真实性和沉浸感。
- 社交媒体: 用户可以创造有趣的内容,例如让自己的照片“说话”,增加用户互动和内容的创新性。
风险与挑战
尽管VASA-1提供了广阔的创新可能,但它也带来了不少挑战和风险。最主要的问题是这种技术可能被用于制造虚假信息或深度伪造视频,这在政治、社会乃至个人层面都可能造成严重的后果。因此,微软在推出VASA-1时采取了极其谨慎的态度,目前尚未向公众提供API或产品实现的详细信息,以防止滥用。
虽然目前VASA-1仍处于研究阶段,未开放公众使用,但它展示了AI技术在音视频合成领域的巨大潜力。未来,随着技术的成熟和相关法律、伦理规范的完善,我们可以期待这类工具能够在保障安全的前提下,为人类社会带来更多创新和便利。