 01 / 01
开源创新open-pose-costume
从参考检索到图像生成:解析 open-pose-costume 的角色创作工作流
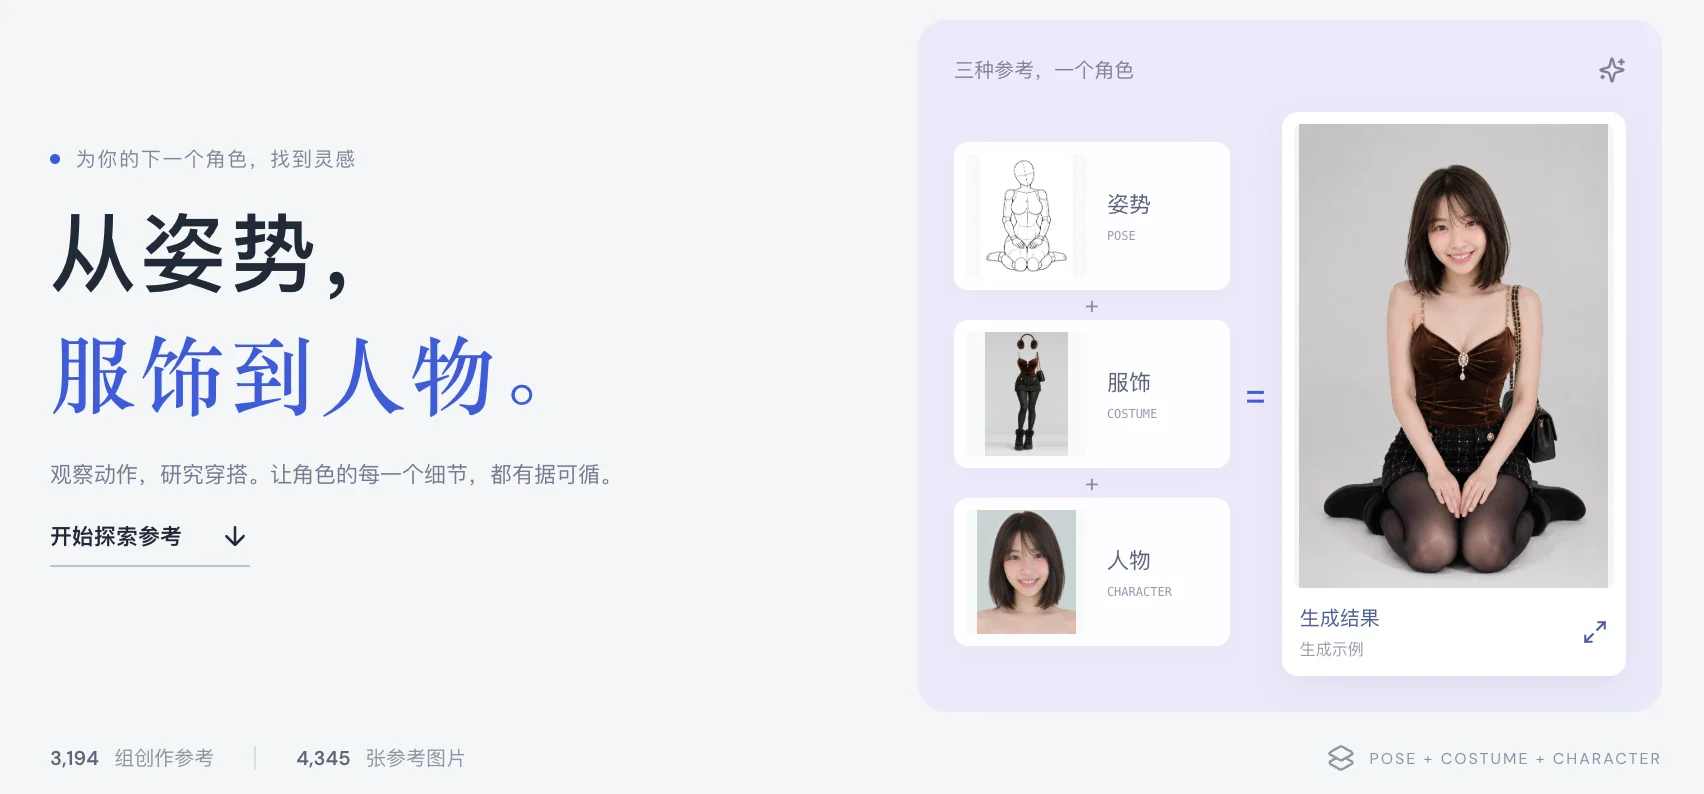
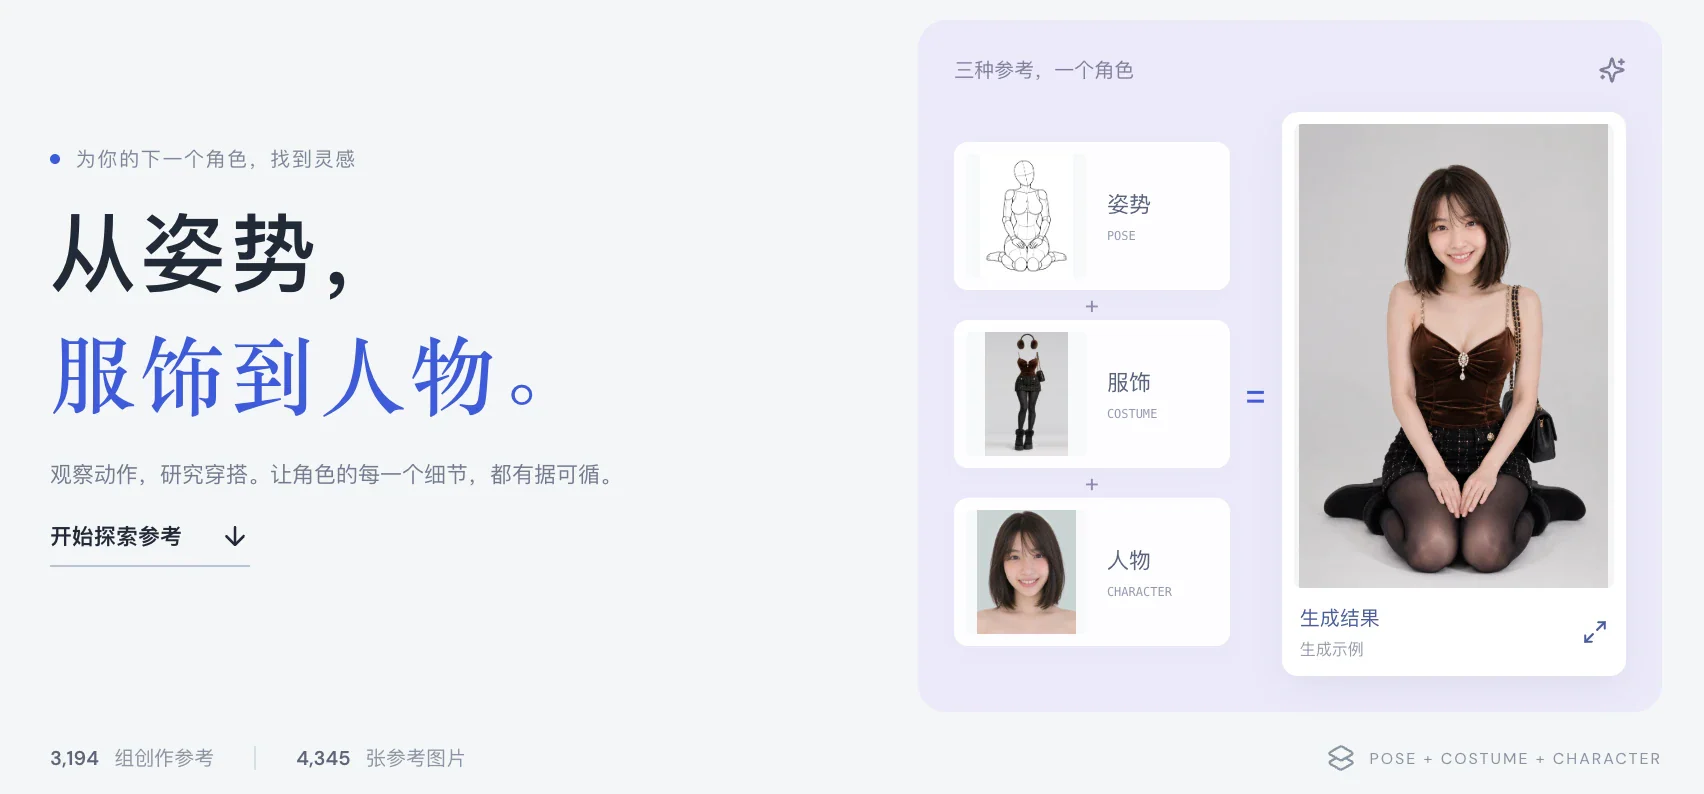
AI角色创作常面临参考素材分散与Prompt具象化断层的问题。开源项目 open-pose-costume 通过工程化手段整合姿势与服装参考库,并集成外部图像生成API,为开发者与插画师提供了一套从素材检索、搭配到生成验证的标准化工作流。
PROJECT DISCOVERY
01 / 01AI角色创作常面临参考素材分散与Prompt具象化断层的问题。开源项目 open-pose-costume 通过工程化手段整合姿势与服装参考库,并集成外部图像生成API,为开发者与插画师提供了一套从素材检索、搭配到生成验证的标准化工作流。
INTELLIGENCE FEED
OpenAI 为 ChatGPT 新增原生 GIF 生成与逐帧编辑功能,并同步推出 Images 2.6 模型以提升图像生成速度与质量。
Canva 推出首个自研图像生成基础模型 Craft,支持 2K 输出与 55 种语言文本生成。该模型通过构图与渲染分离技术优化设计排版,现已通过 Dream Lab 和 API 开放。
微软发布第一方自研图像生成模型 MAI-Image-2.6-Flash,生图速度达 GPT Image 2 的 2 倍,GPU 效率提升 72%,API 定价显著低于竞品,面向大规模图像生成场景提供高性价比方案。
OpenAI发布新一代图像模型GPT Image 1.5,在基准测试中领先但用户反馈两极分化。新模型技术提升显著且成本降低20%,但在中文文本和图像真实度方面存在不足。
OpenAI正在测试代号Hazelnut和Chestnut的AI图像模型,显示出加速视觉生成技术迭代进程。新模型在代码渲染和场景理解上有显著提升,但面部皮肤质感处理仍存在局限性。
谷歌推出全新图像生成模型Nano Banana Pro,具备突破性生成控制力和文字渲染能力。百度秒哒在模型发布当天完成集成,用户无需API密钥即可直接调用该AI图像解决方案。
谷歌发布Nano Banana Pro文生图模型升级版本,无缝整合Gemini 3 Pro多模态能力和Veo 3视频技术,实现复杂场景图像生成与跨语言文本渲染。新模型覆盖多层级用户生态,支持第三方工具集成,并通过SynthID水印技术强化安全验证。
Adobe推出新一代Firefly Image 5模型实现原生400万像素图像生成,大幅提升细节还原精度。Photoshop、Premiere Pro等全线工具新增AI功能,涵盖多模型切换、智能遮罩及多模态创作能力。
谷歌DeepMind正式推出Gemini 2.5 Flash Image图像模型,优化了速度与上下文理解,支持基于文本提示的精准编辑。该模型在LMArena基准测试中表现领先,提供安全机制,开发者可通过Gemini API等访问,输出定价为每百万token 30美元。